AI 产业 (1):算力芯片
AI 已成为芯片行业的主要推动力,而算力芯片处在它的中心。
芯片类型
算力芯片主要有四种,从最通用到最专用。一块芯片越是为单一任务而造,效率就越高,灵活性就越低。
CPU
中央处理器(Central Processing Unit,CPU) 是运行计算机程序的通用处理器。它只有少量复杂的核心(几十到几百个),每个核心都用来按顺序执行指令,处理每一步都依赖上一步的工作。
- CPU 什么都能做,但最擅长操作系统和逻辑。
- CPU 做大规模并行数学运算(也就是 AI)很慢。
- 每台计算机都用 CPU。
- 在 AI 服务器里,CPU 运行操作系统,准备并加载数据,并协调各个 GPU。
- x86 与 Arm: 两种主要的指令集。x86 归英特尔所有,AMD 获得授权生产 x86 CPU。任何人获得 Arm 的授权后都可以设计 Arm CPU。
- 数据中心使用服务器 CPU,个人电脑和笔记本使用客户端 CPU。
| 设计 | 公司 | 服务器 | 客户端(电脑、笔记本、手机) |
|---|---|---|---|
| x86 | 英特尔(Intel) | 至强(Xeon) | 酷睿(Core) |
| x86 | AMD | 霄龙(EPYC) | 锐龙(Ryzen) |
| x86 | 海光信息 | 海光 7000、5000 系列 | 海光 3000 系列 |
| x86 | 兆芯 | 开胜 | 开先 |
| Arm | 亚马逊(Amazon) | Graviton | |
| Arm | 谷歌(Google) | Axion | |
| Arm | 微软(Microsoft) | Cobalt | |
| Arm | 英伟达(Nvidia) | Vera、Grace | |
| Arm | Ampere(软银) | AmpereOne、Altra | |
| Arm | 华为(海思) | 鲲鹏 | 麒麟 |
| Arm | 飞腾 | 腾云 S 系列 | 腾锐 D 系列 |
| Arm | 阿里巴巴(平头哥) | 倚天 | |
| Arm | 苹果(Apple) | M 系列、A 系列 | |
| Arm | 高通(Qualcomm) | 骁龙(Snapdragon) | |
| LoongArch | 龙芯中科 | 龙芯 3C6000 | 龙芯 3A6000 |
(亚马逊、谷歌、微软和阿里巴巴的芯片只在自家云上使用,不对外销售。)
GPU
图形处理器(Graphics Processing Unit,GPU) 是一种拥有数千个小而简单的核心的处理器,能同时对大量数据执行同一种运算。软件把问题拆成相同的小块,由 GPU 并行执行。
- GPU 最初是为图形而造的。
- GPU 做大规模并行数学运算极快,而且可编程。
- GPU 耗电大、价格高,并且始终需要 CPU 来指挥。
- 数据中心用 GPU 做 AI 训练和推理;游戏电脑用它处理图形;汽车用它做辅助驾驶和自动驾驶。
- 独立 GPU 与集成 GPU: 前者是一块单独的芯片,后者是内置在 CPU 或 SoC(System on a Chip,系统级芯片)里的小型 GPU。AI GPU 都是独立 GPU。
- CUDA 是英伟达用来为其 GPU 编程的软件层。
| 公司 | 数据中心 | 客户端(电脑、游戏) |
|---|---|---|
| 英伟达(Nvidia) | Rubin、Blackwell(B200)、Hopper(H100) | GeForce RTX |
| AMD | Instinct(MI400、MI350、MI300) | Radeon |
| 英特尔(Intel) | Arc(锐炫) | |
| 海光信息 | 深算(DCU) | |
| 摩尔线程 | MTT S5000、S4000 | MTT S80 |
| 沐曦 | 曦云 C 系列 | |
| 壁仞科技 | 壁砺(BR100 系列) | |
| 天数智芯 | 天垓、智铠 |
FPGA
现场可编程门阵列(Field Programmable Gate Array,FPGA) 是一种内部电路在制造完成后还能重新布线的芯片。它可以被配置成执行某一任务的电路,之后再重新加载去做另一个任务。
- 为 FPGA 做设计比为 CPU 和 GPU 难得多。
- FPGA 不需要工厂就能得到定制电路的速度 — 几天就能就绪,部署之后还能修改。
- FPGA 在 AI 中只占很小一部分。它的主要用途是电信、网络设备、国防和高频交易。
ASIC
专用集成电路(Application-Specific Integrated Circuit,ASIC) 是一种电路为单一任务定制设计、并且在制造时永久固定的芯片。
- ASIC 在单一任务上提供最高的性能和能效,在出货量极大时单颗成本最低。
- ASIC 放弃了灵活性,并且需要一大笔前期投入。
- 超大规模云厂商(hyperscaler),即最大的几家云公司(谷歌、亚马逊、微软、Meta),都在自研 ASIC。
AI 加速器
| 公司 | 芯片 | 设计伙伴 |
|---|---|---|
| 谷歌(Google) | TPU(Tensor Processing Unit,张量处理器) | 博通(Broadcom) |
| 亚马逊(AWS) | Trainium | 美满电子(Marvell)、世芯(Alchip) |
| 微软(Microsoft) | Maia | 创意电子(Global Unichip,据报道) |
| Meta | MTIA | 博通(Broadcom) |
| 华为 | 昇腾(910C、950) | 自研(海思) |
| 阿里巴巴 | 真武、含光 | 自研(平头哥) |
| 百度 | 昆仑芯(M100) | 自研(昆仑芯) |
| 腾讯 | 紫霄 | 自研 |
| 寒武纪 | 思元 | 自研,对外销售 |
| 燧原科技 | 云燧 | 自研,对外销售 |
NPU
神经网络处理器(Neural Processing Unit,NPU) 是一种用于神经网络运算的小型低功耗加速器。它让 AI 模型在设备本身运行,而不是在数据中心运行。
- NPU 运行在手机、笔记本、汽车和摄像头里。
- NPU 不能做训练,只能做推理。
- NPU 在本地设备上运行,所以不需要联网连接数据中心。
| 公司 | 芯片 | 对 NPU 的叫法 | 用于 |
|---|---|---|---|
| 苹果(Apple) | A 系列、M 系列 | 神经网络引擎(Neural Engine) | iPhone、iPad、Mac |
| 高通(Qualcomm) | 骁龙(Snapdragon) | Hexagon NPU | 安卓手机、Windows 笔记本 |
| 英特尔(Intel) | 酷睿 Ultra(Core Ultra) | Intel AI Boost | Windows 笔记本和台式机 |
| AMD | 锐龙 AI(Ryzen AI) | XDNA | Windows 笔记本和台式机 |
| 联发科(MediaTek) | 天玑(Dimensity) | MediaTek NPU | 安卓手机 |
| 谷歌(Google) | Tensor | TPU | Pixel 手机 |
| 华为(海思) | 麒麟 | NPU | 华为手机、平板 |
| 小米 | 玄戒 | NPU | 小米手机、平板 |
| 地平线 | 征程 | BPU | 汽车 |
| 瑞芯微 | RK3588 | NPU | 摄像头、边缘设备 |
DPU
数据处理器(Data Processing Unit,DPU) 是一种把用于网络、存储和安全的固定电路与自带的几个 CPU 核心结合在一起的芯片。
- DPU 把这些任务从服务器的主 CPU 上卸下来。
- DPU 常见于数据中心。
- 在 AI 服务器里,DPU 让数据持续流动,使昂贵的 GPU 不必空等数据。
| 公司 | 产品 |
|---|---|
| 英伟达(Nvidia) | BlueField |
| AMD | Pensando |
| 美满电子(Marvell) | OCTEON |
| 英特尔(Intel) | IPU |
| 亚马逊(Amazon) | Nitro |
| 阿里云 | CIPU |
| 中科驭数 | K2-Pro |
| 云豹智能 | 云霄 |
GPU 如何工作
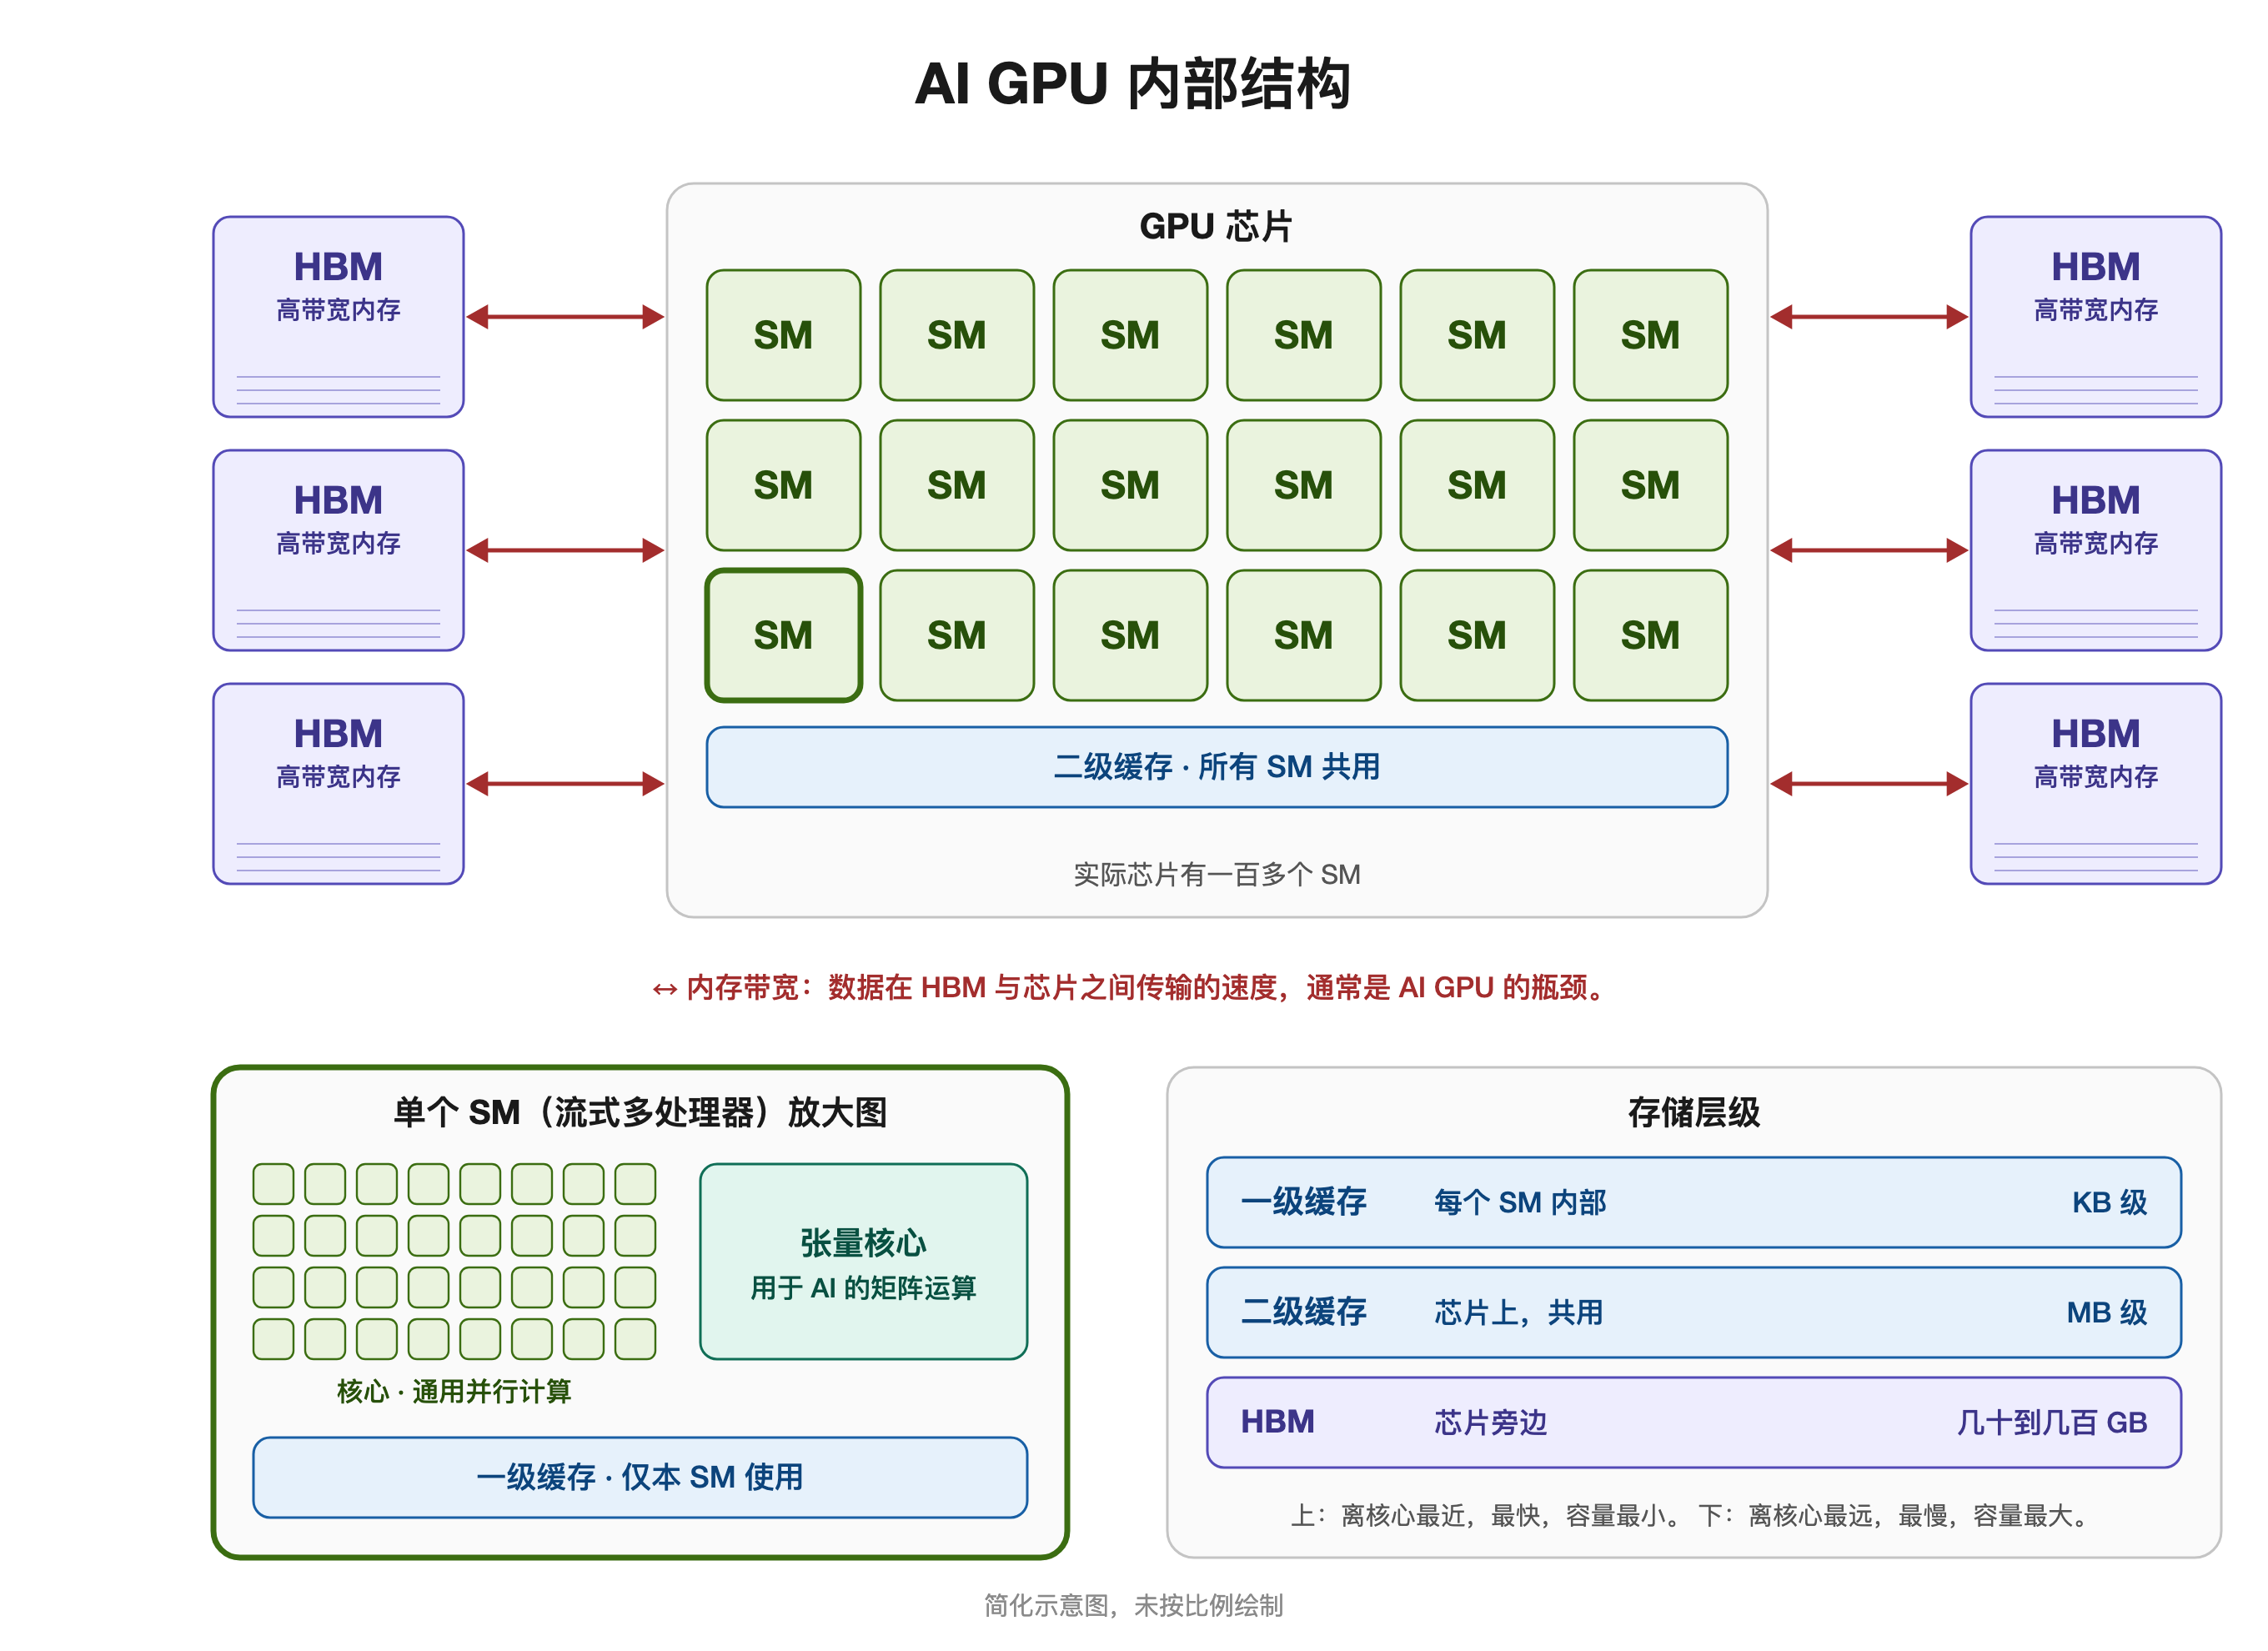
在这四种芯片里,GPU 承担了今天大部分的 AI 工作,因为它非常擅长矩阵乘法,也就是 AI 所依赖的数学运算。
核心 — SM 与张量核心
流式多处理器(Streaming Multiprocessor,SM) 是 GPU 的基本处理单元。
- 一块 GPU 有一百多个 SM。每个 SM 独立工作,与其他 SM 并行。
- 每个 SM 包含普通核心、张量核心,以及一小块高速内存(它的一级缓存)。
- 普通核心做通用的并行运算。
- 张量核心只做矩阵乘法。GPU 的 AI 速度大部分来自它们。
- SM 越多,算力越强,但前提是内存供数据的速度跟得上。
内存与内存带宽
内存带宽是数据在 GPU 的内存与核心之间传输的速度。
- 容量(GB)决定能装下多大的模型。
- 带宽(GB/秒)决定模型运行得多快。
- 高带宽内存(High-bandwidth memory,HBM) 是把内存芯片一层层堆叠起来、并垂直贯穿整个堆叠直接连线的内存,紧挨着 GPU 放置。参见 03 Memory 存储芯片。
工作负载
知道了 GPU 能做什么,下一个问题是它被要求做什么。
一个 AI 模型是一大组数字,称为权重。训练是找出这些数字,推理是使用它们。
| 工作负载 | 地点 | 芯片 |
|---|---|---|
| 训练 | 数据中心 | GPU |
| 推理 | 数据中心 | GPU 和 ASIC |
| 推理 | 设备端 | NPU |
训练
训练就是找出模型的权重 — 给模型看数据,衡量它的误差,再把每个权重微调一点,如此重复上万亿次。
- 训练需要最大的算力。一个模型要在数千块连在一起的 GPU 上训练。
- 训练需要的内存比模型本身更大。
推理
推理是运行一个已完成的模型来回应请求。权重是固定的,数据只通过模型一次。
- 每个用户的每次请求都要做推理,所以它的成本是随使用量增长的持续成本。
- 推理芯片比拼的是每个 token 的成本和响应时间。
- 每生成一个 token 都要把整个模型从内存里读一遍,所以内存带宽是主要的限制。
软件
AI 训练和推理都需要软件才能在芯片上运行。每家芯片厂商都提供自己的软件,目前英伟达的领先。
CUDA
CUDA 是英伟达用来为其 GPU 编程的平台。它是免费的,但只能在英伟达的 GPU 上运行。
为 CUDA 写的代码要在别家的芯片上运行就得重写,这个成本把客户锁住了。这种锁定在研究和训练中最强,因为那里的设计一直在变。对于在自家芯片上运行固定模型的超大规模云厂商,它最弱。
替代方案
| 公司 | 软件 | 定位 |
|---|---|---|
| AMD | ROCm | 开源。CUDA 的直接对手,覆盖面仍然落后。 |
| 英特尔(Intel) | oneAPI | 在 AI 中份额很小。 |
| 谷歌(Google) | 为 TPU 自建的软件栈(JAX、TensorFlow) | 很强,但服务于谷歌自己的芯片。 |
| 亚马逊(Amazon) | 为 Trainium 自建的工具包 | 服务于亚马逊自己的芯片。 |
| Meta 等 | PyTorch,一个框架 | 中立:可在多种芯片上运行。 |
| 华为 | CANN、MindSpore(昇思) | 服务于华为自己的昇腾芯片。 |
| 寒武纪 | NeuWare | 服务于寒武纪自己的芯片。 |
| 摩尔线程 | MUSA | 服务于摩尔线程自己的 GPU。 |
| 百度 | 飞桨(PaddlePaddle),一个框架 | 可在多种芯片上运行。 |
如何制造与销售
这个行业里的公司设计芯片,但大多不自己制造。它们每年推出新一代产品,并把大部分卖给少数几家非常大的买家。
无晶圆厂模式
无晶圆厂(fabless) 公司只设计芯片,不拥有工厂(芯片工厂称为晶圆厂,fab)。晶圆代工厂(foundry) 制造其他公司设计的芯片。
| 模式 | 做什么 | 例子 |
|---|---|---|
| 无晶圆厂 | 只设计 | 英伟达、AMD、博通、美满电子、海思、寒武纪、海光信息 |
| 晶圆代工 | 只制造 | 台积电、中芯国际、华虹 |
| 垂直整合 | 既设计也制造 | 英特尔、三星 |
设计周期与一年一代的节奏
设计周期是一款芯片从最初构想到出货所需的时间,大约两到三年。节奏是新一代产品多久出货一次 — 英伟达和 AMD 是一年。
- 一年一代的节奏需要非常高的研发投入。
谁在买
| 买家 | 是谁 | 角色 |
|---|---|---|
| 超大规模云厂商 | 亚马逊、微软、谷歌、Meta、甲骨文;阿里巴巴、腾讯、字节跳动、百度 | 份额遥遥领先 |
| 新型云厂商(neocloud) | CoreWeave 等 | 出租 GPU;规模较小,增长很快 |
| AI 实验室 | OpenAI、Anthropic、xAI | 主要通过云厂商购买 |
| 企业 | 普通公司 | 份额较小,通常通过云厂商 |
| 政府 | 国家级 AI 项目(主权 AI) | 较新的一类 |
- 少数几家买家占了收入的很大一部分。
- 超大规模云厂商在数据中心上的资本开支(capex)是衡量 AI 芯片需求最好的单一指标。
- 最大的客户同时也是竞争对手。正是它们在自研 ASIC。
衡量性能
这些买家评判一款芯片,看的是它干活的成本,而不是它的规格。
| 指标 | 衡量什么 | 为什么对生意重要 |
|---|---|---|
| 每瓦性能 | 每单位电力完成的工作量 | 数据中心的电力是固定的,所以它决定了数据中心能产出多少 |
| 总拥有成本(TCO) | 一款芯片在整个寿命内拥有和运行它的全部成本:芯片、电力、散热、机房、网络 | 买价更高的芯片,拥有成本可能更低 |
| 每 token 成本 | 一单位输出最终的成本 | 推理芯片比拼的数字 |
| 吉瓦(GW) | 已部署芯片的电力容量 | 现在订单和数据中心的规模是这样计量的 |
- 数据中心的电力供应是固定的,所以它的收入大致等于它的电力乘以每瓦产出的 token 数。这就是为什么每瓦性能比芯片价格更重要。
- 芯片厂商以总拥有成本和每 token 成本来销售,所以更贵的芯片可能是更便宜的选择。